Medindo o Insolúvel: um estudo comparativo do Liber Primus (Cicada 3301) e do Manuscrito Voynich
Falsificação, estatísticas discriminativas e os limites da IA na criptoanálise histórica
Versão em inglês Measuring the Unsolvable: A Comparative Study of the Liber Primus (Cicada 3301) and the Voynich Manuscript
Matheus Soranço · Criador do I.S.A.A.C. (Intelligent Scientific Analysis & Analytics Core) · Pesquisador de IA, ciência da computação, criptoanálise, filosofia da mente
Preprint, não submetido a nenhum veículo. Nenhuma decifração é alegada. Código: licença Apache 2.0. Texto do artigo: CC BY 4.0. Repositórios: LiberPrimus e Voynich (GitHub: Matheussoranco).
Esta página é a versão web do preprint, com correções e um apêndice acrescentados em novembro de 2026; veja as notas de revisão no fim. O PDF como foi escrito originalmente, em inglês, fica guardado para consulta. A tradução segue o texto em inglês desta página.
Resumo
O Liber Primus (Cicada 3301) e o manuscrito Voynich são dois dos textos cifrados não resolvidos mais famosos. Ambos acumularam mais de um século de “soluções” mutuamente incompatíveis, a maioria infalsificável. Este artigo relata dois programas de pesquisa independentes, um para cada artefato, que compartilham uma única regra metodológica: apresentar toda estatística ao lado de modelos nulos que deveriam reprová-la e amarrar todo ataque a controles de resposta conhecida, tirados da mesma classe de cifra.
Para o Liber Primus, um motor de falsificação exclui sete classes de cifra nas seis seções não resolvidas (11.081 runas), incluindo chaves corridas (running keys) em língua natural por meio de um argumento de convolução (), e documenta como um aparato substancial de busca por aprendizado de máquina classificou um texto claro rotacionado acima do texto claro verdadeiro numa página já resolvida. Uma análise homofônica variacional posterior encontra heterogeneidade entre as seções: três compatíveis com inglês homofônico, uma decisivamente excluída, duas inconclusivas.
Para o manuscrito Voynich, uma bateria discriminativa testada contra quatro modelos nulos que retêm estrutura mostra que a lei de Zipf, a entropia condicional e a rigidez posicional são todas reproduzidas por uma cadeia de Markov de ordem 2 sobre caracteres, ajustada aos glifos do próprio manuscrito: elas quase não discriminam nada. Dois achados sobrevivem aos controles: Currier A e B são populações distintas, e o efeito da linha como unidade funcional (divergência de 12× no nível do glifo e de 23× no nível da palavra, sobre um controle de caracteres embaralhados) resiste a qualquer cifra de substituição ou transposição de língua natural.
O artigo conclui com uma discussão sobre onde a IA se encaixa neste domínio (geração de hipóteses e construção de corpus, fora do laço de pontuação) e onde não se encaixa (como juíza dentro dele).
1. Introdução
O Liber Primus é um códice rúnico lançado pelo grupo Cicada 3301 durante a rodada de enigmas de 2014, escrito num alfabeto de 29 caracteres publicado como Gematria Primus, que associa runas derivadas do Futhark Antigo a um índice e a um valor primo. Quatro seções foram decifradas pela comunidade e lidas como texto aforístico e instrucional em inglês; seis permanecem sem solução, somando 11.081 runas. O manuscrito Voynich é um códice ilustrado datado por radiocarbono do início do século XV (c. 1404–1438), escrito numa escrita desconhecida (o voynichês) em cerca de 240 fólios de velino. Apesar de mais de um século de atenção profissional e amadora contínua, nenhum dos dois foi decifrado de forma convincente.
O que une os dois domínios não é apenas a fama, mas a epistemologia. Um artefato não resolvido não tem verdade de referência contra a qual conferir uma afirmação positiva. Se um procedimento produz um texto que parece inglês ou latim medieval, nenhum oráculo independente o confirma. A consequência é um longo histórico de “soluções” confiantes e mutuamente incompatíveis. No domínio do Voynich isso inclui trabalhos que passaram por revisão por pares antes de serem retirados. No domínio do Liber Primus, a comunidade produziu um registro vasto de hipóteses, com pouca disciplina metodológica.
Este artigo não tenta resolver nenhum dos dois artefatos. Ele relata programas de medição desenhados para que os resultados negativos signifiquem algo. A regra central, aplicada mecanicamente nos dois projetos, é o controle como condição de admissão (control gating). Todo ataque é amarrado a (1) uma classe de cifra nomeada e com tamanho quantificado, (2) controles de resposta conhecida, tirados dessa mesma classe e gerados pelas primitivas do próprio ataque, e (3) um procedimento aplicado ao texto cifrado real. O relatório de um ataque só é admissível se seus controles passarem; caso contrário, o veredito é INCONCLUSIVO, uma afirmação sobre a ferramenta, não sobre os dados.
Uma regra secundária é a bateria discriminativa: uma estatística só é admitida se separar o artefato de modelos nulos que são sem sentido por construção. Os modelos nulos são ordenados pela estrutura que retêm: texto aleatório uniforme, texto de caracteres embaralhados, Markov de ordem 1, Markov de ordem 2. Uma estatística que quase tudo passa não pode sustentar uma conclusão, por mais firmemente que o artefato a passe.
Meu interesse pessoal nesses dois projetos é antigo. O fascínio pelo Liber Primus começou com a Cicada 3301 e virou um programa de pesquisa pessoal que combina criptoanálise computacional com aprendizado de máquina. O interesse pelo Voynich é ainda mais antigo: a curiosidade sobre se a estrutura estatística pode algum dia estabelecer o estatuto linguístico de um texto. Os dois projetos são conduzidos como pesquisa: as falhas são preservadas, o que funciona é medido, e as conclusões são mantidas menores que a curiosidade.
2. Fundamentos Matemáticos e Criptográficos
2.1 Índice de Coincidência (IC)
O índice de coincidência é a probabilidade de que dois símbolos sorteados independentemente de um texto sejam idênticos. Para um alfabeto de tamanho e contagens de símbolos num texto de comprimento :
Para texto uniforme sobre símbolos, . Para o inglês, . Uma cifra de substituição preserva o IC exatamente (é uma bijeção); uma transposição preserva a distribuição de unigramas e, portanto, o IC; uma chave corrida convolui as distribuições do texto claro e da chave, achatando o resultado sem uniformizá-lo, a menos que os espectros das duas distribuições sejam disjuntos (Seção 3.3 e Apêndice A.2). Este último fato, o argumento da convolução, é o que permite a exclusão, em nível de classe, de chaves corridas em língua natural sem percorrer o espaço ilimitado de chaves.
2.2 Entropia e Entropia Condicional
Entropia de unigramas . Entropia condicional de primeira ordem , estimada com correção de viés de Miller–Madow. A entropia máxima para 29 runas é bits. baixo indica previsibilidade sequencial. As estimativas de entropia têm viés para baixo em textos curtos; a correção é aplicada e os valores brutos são informados ao lado, porque um estimador sem correção pode fabricar um achado de “entropia incomumente baixa”.
2.3 Lei de Zipf
Lei de Zipf: a frequência do item de posto segue . Um ajuste de mínimos quadrados do log da frequência contra o log do posto produz o expoente e o . A conformidade com Zipf vale para o voynichês (, ), mas vale também para uma cadeia de Markov de ordem 2 sobre caracteres, ajustada aos glifos do próprio manuscrito (, ). A estatística não as separa; portanto a conformidade com Zipf não é evidência de que o voynichês codifique língua.
2.4 Controle como Condição de Admissão e o Reticulado de Vereditos
Todo ataque traz uma hipótese, controles e um procedimento. Os controles são problemas de resposta conhecida da mesma classe de cifra, gerados pelas primitivas de cifra do próprio ataque. O reticulado de vereditos distingue REFUTADO (controles passaram, a classe inteira foi coberta, nada encontrado) de NÃO_ENCONTRADO (controles passaram, um subconjunto foi pesquisado, nada encontrado: evidência contrária, não prova), CANDIDATO (controles passaram, algo pontuou na faixa do texto claro: encaminhamento para revisão humana, não solução), INCONCLUSIVO (controles falharam: uma afirmação sobre a ferramenta) e NÃO TESTADO. Os controles devem corresponder à escala do alvo: validar no comprimento de texto errado não prova nada, e a direção perigosa é licenciar uma afirmação que o controle nunca testou.
3. Liber Primus: Falsificar, Não Resolver
3.1 O Que Está Sendo Testado
| Hipótese | Espaço de chaves | Método | Cobertura | Veredito |
|---|---|---|---|---|
| Texto claro sem cifra | 1 | IC contra o nulo do texto claro (Figura 1) | Exaustiva | REFUTADA |
| Substituição afim | 812 | Enumeração completa | Exaustiva | REFUTADA |
| Substituição monoalfabética geral | Invariante do IC + subida de encosta | Exaustiva via invariante | REFUTADA | |
| Transposição pura | 161 | Enumeração completa | Exaustiva | REFUTADA |
| Keystream teórico-numérico determinístico | 6.144 | Enumeração completa | Exaustiva | REFUTADA |
| Vigenère / Beaufort periódica | até | exato por coset | Exaustiva até | REFUTADA |
| Chave corrida (texto em língua natural) | Ilimitado | Busca direta + IC da convolução | Parcial / em nível de classe | REFUTADA |
Duas exclusões são exatas sem enumeração. A substituição monoalfabética tem chaves, mas o IC é invariante sob qualquer bijeção do alfabeto: uma única medição decide sobre todas as chaves de uma vez. Cifras polialfabéticas periódicas com período reduzem-se a cosets de César independentes; recuperar o melhor deslocamento por coset custa 29 avaliações cada, de modo que a varredura completa até , nos dois modos, é de cerca de 106.000 avaliações (), menos de um segundo.
3.2 Modelos Nulos: Excluir Classes Sem Percorrê-las
Para cada hipótese generativa, simulam-se textos cifrados sintéticos no comprimento verdadeiro () e mede-se a mesma estatística (IC). O observado é comparado com a distribuição de referência. A compatibilidade exige ao mesmo tempo e que a observação esteja dentro da faixa que o nulo de fato produziu, porque os nulos periódicos têm assimetria à direita e um modesto pode esconder uma observação abaixo de todos os sorteios simulados.
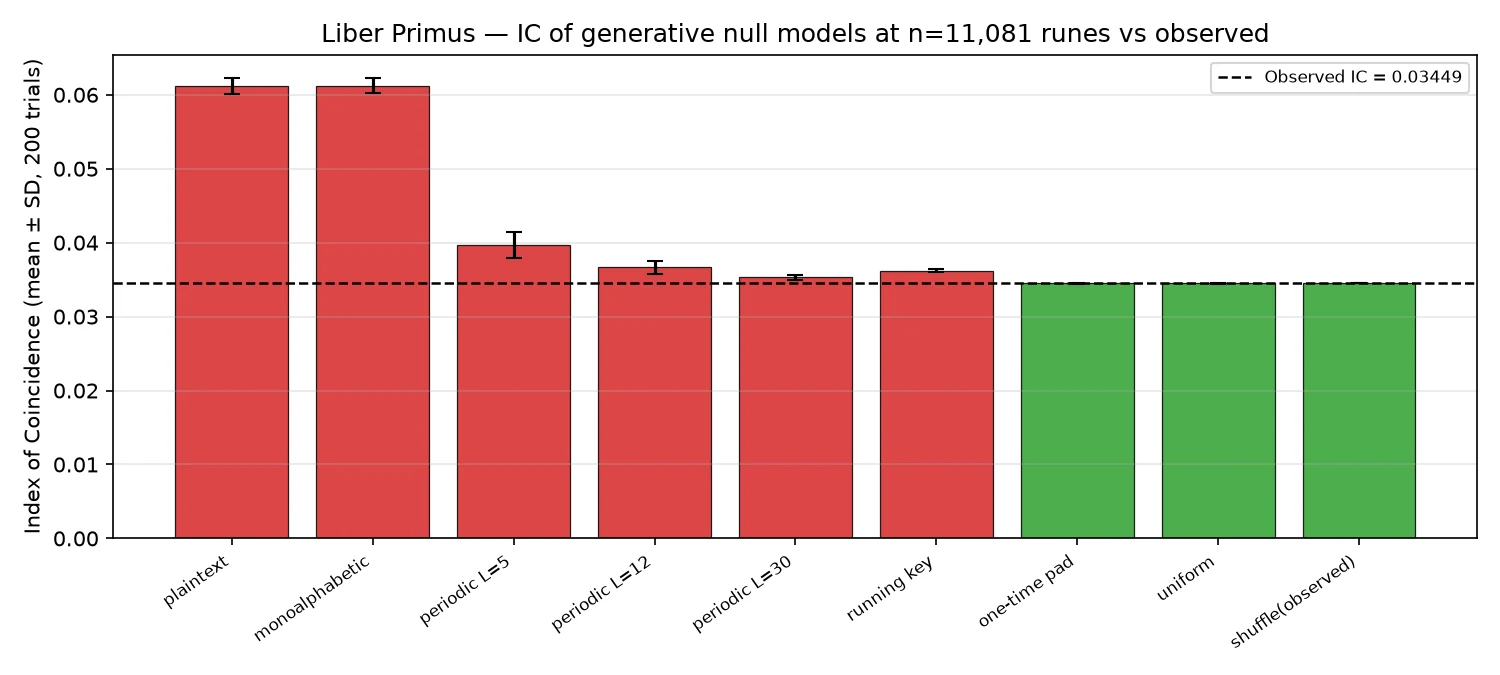
Figura 1. Índice de coincidência de modelos nulos generativos com runas (média ± DP em 200 tentativas). O valor observado (0,03449) é incompatível com os modelos de texto claro, monoalfabético, periódico e de chave corrida, e compatível com one-time pad, uniforme e embaralhamento posicional de si mesmo.
3.3 O Argumento da Convolução para a Chave Corrida
Uma chave corrida cifra o texto claro com uma chave tirada de outro texto em língua natural. Seja a distribuição do texto claro e a da chave, sobre . Sob combinação aditiva, a distribuição do texto cifrado é a convolução circular . Em termos de Fourier, , e como é proporcional à norma ao quadrado da parte não constante:
Todos os termos são não negativos. O excesso sobre o uniforme é zero se e somente se, em toda frequência não nula, pelo menos um entre e se anula. Uma distribuição de letras de língua natural não tem coeficientes de Fourier nulos; assim, a convolução achata a distribuição, mas não consegue torná-la uniforme. O observado fica abaixo do nulo da chave corrida (; em 200 tentativas a estatística nunca caiu abaixo de ).
3.4 Por Que a Arquitetura de Aprendizado de Máquina Falhou
A versão anterior do código do Liber Primus (~3.200 linhas) implementava um algoritmo genético em modelo de ilhas, um arquivo de qualidade-diversidade MAP-Elites, CMA-ES, MCTS no estilo AlphaZero, um agente PPO com ator-crítico Transformer e um crítico neural de modelo de linguagem, todos buscando numa DSL de cifras componível. Nenhum produziu um resultado utilizável.
A medição decisiva: na seção 0.0 (já resolvida, cifra Atbash), a busca em feixe devolveu uma rotação cíclica do texto claro verdadeiro e a pontuou acima da verdade de referência ( contra ). Uma rotação cíclica deixa unigramas e IC exatamente invariantes, e dos quadrigramas sobrevivem intactos (só os três quadrigramas que atravessavam o corte são trocados por três que atravessam a nova junção); assim, há iscas de pontuação quase igual para cada solução genuína. Nenhuma pontuação pode certificar uma decifração. O arquivo MAP-Elites colapsou numa única célula comportamental com dados reais; o agente de RL controlava o nome da operação enquanto o ambiente sorteava os argumentos (todo o problema, no caso de Vigenère); a primitiva COLUMNAR perdia informação em silêncio embora marcada como invertível; e 19 testes passaram porque verificavam o comprimento da saída, não a recuperação.
A lição geral: mais poder de otimização aplicado a um objetivo não validado produz respostas erradas mais confiantes. Para uma cifra não resolvida, o recurso escasso não é computação, é falseabilidade. O aprendizado de máquina tem lugar fora do laço de pontuação, como gerador de hipóteses e construtor de corpus cuja saída um humano revisa; nunca como juiz dentro dele.
3.5 Análise de Substituição Homofônica (trabalho posterior)
Todas as exclusões acima dependem do invariante do IC ou de sua generalização por coset, que só se aplicam a mapeamentos bijetivos de símbolos. A substituição homofônica ou de nomenclador, em que vários símbolos cifrados correspondem a uma mesma letra do texto claro, achata a distribuição de unigramas antes da combinação e escapa inteiramente ao teste de IC. Um ataque de inferência variacional aprende uma atribuição suave das runas cifradas às letras do texto claro, minimizando a divergência KL entre a distribuição de bigramas decodificada e um modelo de referência em inglês normalizado pela Gematria, calibrado contra nulos uniformes aleatórios no comprimento verdadeiro.
| Seção | Veredito | ||||
|---|---|---|---|---|---|
| 0.7 (raízes) | 1,99 | 3,89 | 0,14 | −13,62 | COMPATÍVEL |
| 0.8 (moebius) | 3,32 | 3,20 | 0,18 | +0,65 | INCONCLUSIVO |
| 0.9 (pontos/efêmera) | 2,35 | 3,55 | 0,29 | −4,22 | COMPATÍVEL |
| 0.10 (asa) | 3,41 | 4,69 | 0,28 | −4,57 | COMPATÍVEL |
| 0.11 (cuneiforme) | 7,96 | 4,27 | 0,15 | +24,60 | EXCLUÍDO |
| 0.12 (plantas) | 3,32 | 4,28 | 1,12 | −0,86 | INCONCLUSIVO |
Aqui é o objetivo otimizado para a seção, e são a média e o desvio-padrão do nulo uniforme aleatório, e . Os vereditos seguem o sinal e o tamanho de : fortemente negativo é compatível com inglês homofônico, próximo de zero é inconclusivo, fortemente positivo é excluído.
As atribuições duras colapsam para uma única letra em várias seções, uma patologia conhecida quando o sinal é fraco demais para resolver mapeamentos individuais. Mesmo assim, os escores cobrem . Tratando as seis seções como se compartilhassem uma única cifra, a dispersão dos escores em torno da média dá com 5 graus de liberdade, uma probabilidade abaixo de sob homogeneidade (Apêndice A.5). As páginas não resolvidas do Liber Primus não são uma cifra homogênea; é necessária análise específica por seção, e a análise agregada é inválida para classes que não são fechadas sob concatenação.
4. Manuscrito Voynich: Medição Contra Nulos
4.1 Dados e Modelos Nulos
Os resultados usam a transcrição IVTFF ZL (Zandbergen–Landini) v3b-n: 227 páginas, 5.385 loci, 37.953 ocorrências de palavras, 8.423 tipos, 193.023 glifos. A transcrição independente de Takahashi/Interlinear (IT2a-n) (225 páginas, 36.907 ocorrências) serve de controle; as contagens de palavras de alta frequência concordam em cerca de 1% (daiin 798 contra 805). Quatro modelos nulos não carregam léxico, gramática nem semântica, ordenados pela estrutura retida: aleatório uniforme + espaços; caracteres embaralhados (preserva exatamente o inventário de glifos e os comprimentos das palavras); Markov de caracteres de ordem 1 (retém estatísticas de glifos adjacentes); Markov de caracteres de ordem 2 (retém contexto de dois glifos).
4.2 A Lei de Zipf Não Decide Nada
O voynichês se ajusta a uma lei de potência de posto-frequência com expoente 1,022 e . A cadeia de Markov de ordem 2 dá expoente 1,064 e : pelo menos tão voynichesca em todos os eixos, sem palavras, sem significado e com 676 estados de memória. O nulo “macaco” ingênuo (uniforme + espaços) é distinguível (, ); logo, uma crítica apoiada só no modelo do macaco seria fraca, mas a cadeia de Markov resolve a questão. A conformidade com Zipf é excluída da bateria discriminativa.
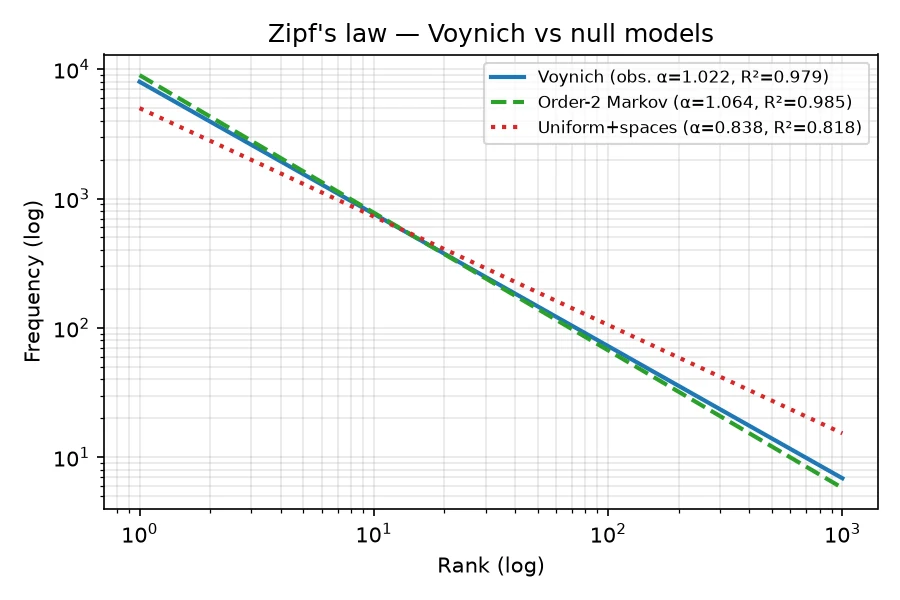
Figura 2. Curvas de posto-frequência de Zipf. O voynichês () é acompanhado de perto por uma cadeia de Markov de ordem 2 ajustada aos seus próprios glifos (); o texto aleatório uniforme com espaços () é visivelmente diferente. A conformidade com Zipf é, portanto, não discriminativa.
4.3 A Bateria Discriminativa
Calcula-se uma bateria de estatísticas para o manuscrito e para os quatro nulos. Uma estatística só é admitida se separar o manuscrito dos nulos; uma estatística que falha é informada como falhando, o que é, em si, um resultado sobre a literatura que a cita.
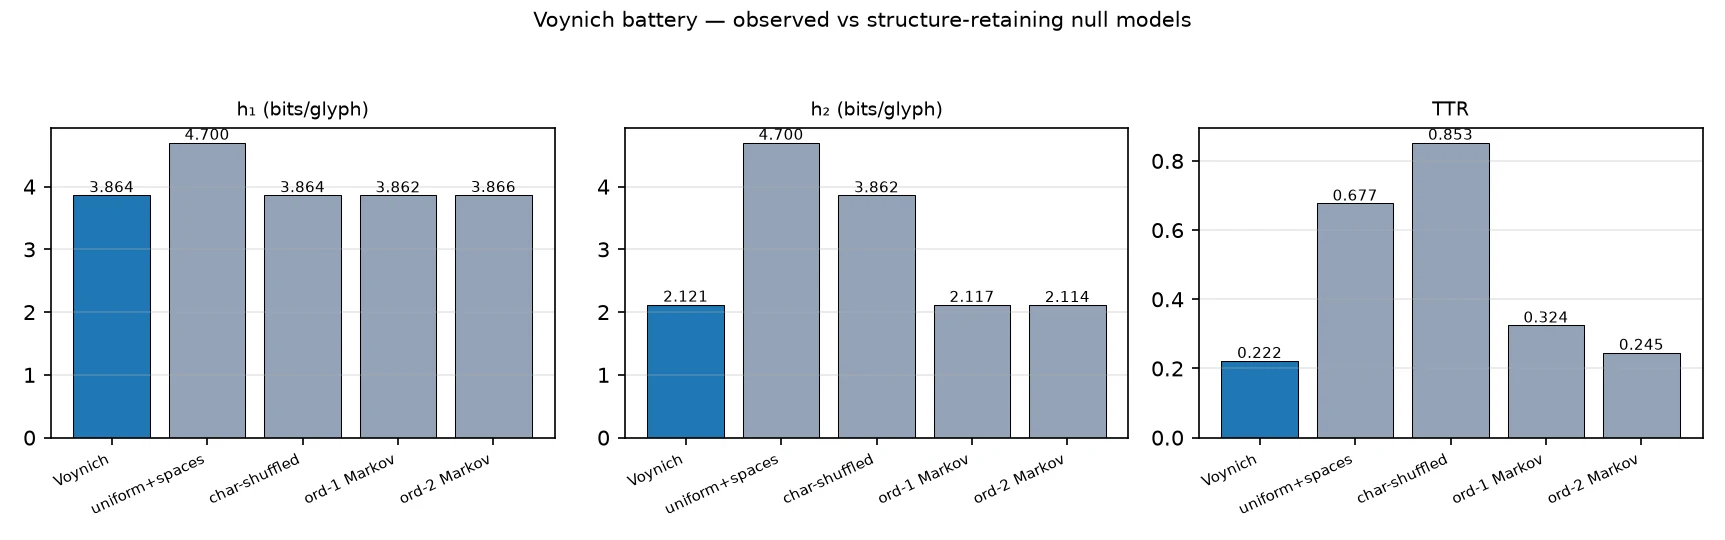
Figura 3. Bateria discriminativa. , e TTR para o Voynich (observado) contra modelos nulos que retêm estrutura. Uma cadeia de Markov de ordem 1 já reproduz , a rigidez, o comprimento médio das palavras e a repetição adjacente; só a variância do comprimento das palavras e o TTR os separam, e a ordem 2 estreita ambos.
Entropia condicional bits para o Voynich, contra 2,117 para o Markov de ordem 1 e 2,114 para o de ordem 2. O controle de caracteres embaralhados, com 3,862 bits, mostra quanto da previsibilidade é estrutura sequencial real. A inferência correta é estreita: essas estatísticas carregam muito pouca informação sobre se o manuscrito tem significado. Texto com significado também tem estrutura de baixa ordem, e é por isso que estatísticas de baixa ordem são evidência fraca nos dois sentidos.
4.4 Dois Achados Que Sobrevivem
Currier A e B são populações distintas. Currier observou em 1976 que o manuscrito é escrito em dois sistemas estatisticamente distintos. Medido aqui: A tem , TTR ; B tem , TTR . Com 100 tentativas de nulo para cada um, as diferenças em , rigidez e TTR são decisivas (); a variância do comprimento das palavras e a repetição adjacente são compatíveis com um único processo. Qualquer explicação precisa dar conta dos dois sistemas; qualquer estatística sobre o manuscrito inteiro faz, em silêncio, a média de duas populações.
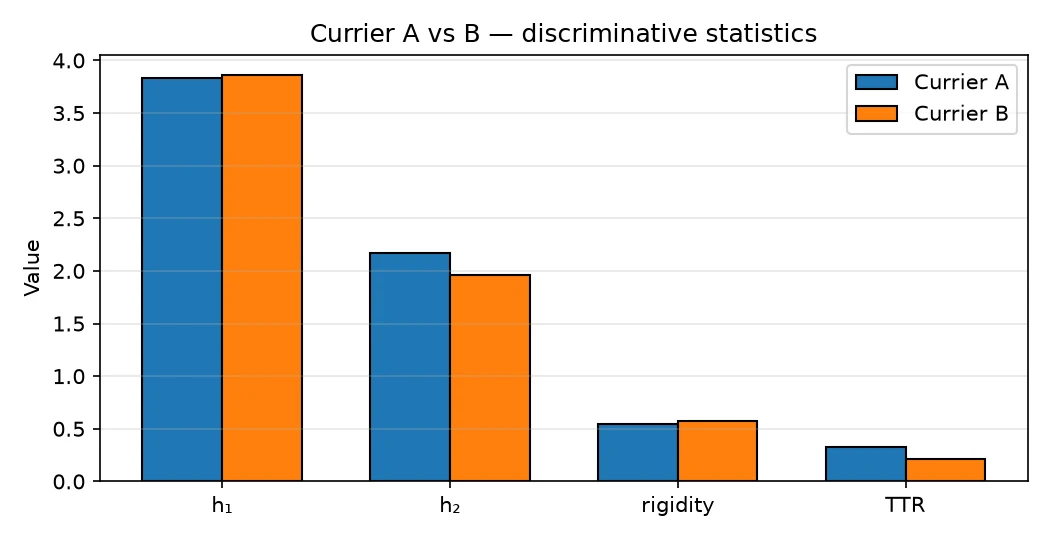
Figura 4. Currier A contra B em estatísticas discriminativas. A e B diferem decisivamente em , rigidez e TTR, mas não na variância do comprimento das palavras nem na repetição adjacente.
A linha é uma unidade funcional. O texto em língua natural não sabe onde o escriba vai quebrar a linha. Uma cifra de substituição age glifo a glifo, sem referência à diagramação; uma transposição permuta um fluxo fixado antes de as linhas existirem. Medindo a distância de variação total entre a distribuição do primeiro glifo das palavras iniciais de linha e a de todas as outras palavras: para o Voynich, para um controle de caracteres embaralhados, uma razão de 12,3×. No nível da palavra, da primeira palavra contra , uma razão de 23,3×. As linhas iniciais de parágrafo formam uma subpopulação ainda mais distinta (primeiros glifos {p, t, k, f, o} contra meio de linha {d, s, y, q, o}). Isso é incompatível com qualquer cifra de substituição ou transposição de uma língua natural em que o texto claro seja produzido independentemente do formato da página.
4.5 Tokenização Alternativa
Todas as conclusões estatísticas são condicionais à tokenização EVA. A tokenização composta (fundir ch, sh, cth em tokens únicos) eleva a entropia condicional de 2,081 para 2,224. Fundir símbolos muda o alfabeto; assim, o novo valor não pode ser comparado com o nulo de ordem 2 ajustado sob EVA (2,114): o nulo precisa ser reajustado sob a mesma tokenização composta antes que a comparação signifique algo (Apêndice A.4). O que o resultado mostra é que a afirmação “o voynichês tem entropia condicional menor que um modelo de 2-gramas de si mesmo” depende da tokenização e não é robusta. As tokenizações por traços, primeiro-último e silábica colapsam ou distorcem, cada uma, estatísticas diferentes, o que confirma que a escolha de tokenização é uma hipótese de modelagem, não uma formatação neutra.
4.6 Convergência da Taxa de Entropia
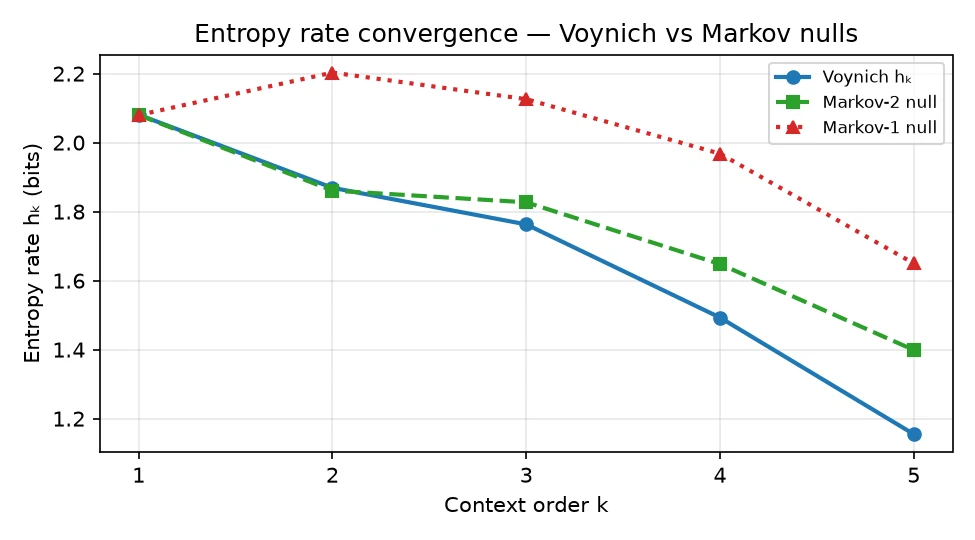
Figura 5. Taxa de entropia contra a ordem de contexto . O Voynich coincide com o nulo de Markov de ordem 2 em e depois cai abaixo dele em , o que aponta dependência além de dois glifos.
Para a língua natural, tipicamente converge para ~1,0–1,5 bits/caractere e continua diminuindo devagar. Para o voynichês, a curva coincide com o nulo de Markov-2 em , onde o nulo reproduz por construção as estatísticas de baixa ordem do manuscrito; a concordância, sozinha, não carrega informação. Em o manuscrito fica abaixo do nulo (por cerca de 0,07, 0,16 e 0,24 bits), e as duas curvas descem em parte porque as estimativas plug-in têm viés para baixo à medida que o número de contextos cresce em direção ao comprimento do texto (Apêndice A.3). O nulo é gerado no comprimento do manuscrito e estimado do mesmo modo; portanto o viés é compartilhado e a diferença não é viés: o manuscrito carrega dependência além de uma memória de dois glifos, coerente com as palavras repetidas e os padrões de pares de palavras que a literatura descreve há tempos. A evidência da taxa de entropia sustenta, assim, a afirmação estreita da Seção 4.3 (uma cadeia de ordem 2 reproduz as estatísticas de ordem ) e não a leitura mais forte de que um processo generativo de memória de 2 glifos produziu o texto.
5. Inteligência Artificial: O Que Foi Tentado, O Que Falhou, O Que Vem Depois
5.1 Abordagens Tentadas
Os dois projetos compartilham uma linhagem de IA: uma bancada de metaaprendizado linguístico, sem dependências, baseada em verossimilhanças de caracteres de 1 a 4 gramas, metatreinada com uma atualização Reptile de primeira ordem ao longo de episódios de cifra/chave (deslocamento de César, substituição afim, Vigenère periódica, autokey de texto claro), avaliando chaves novas e janelas retidas. O resultado de controle: top-1 sem treino = 6,25%; top-1 com metainicialização = 100%; do zero + adaptação com suporte = 100%. Este é um resultado de controle, não evidência sobre o manuscrito: mostra que o aprendiz de características classifica a resposta plantada quando a família de cifra correta e o conjunto de candidatos a contêm. A adaptação a partir do zero também alcança o teto; logo, não se demonstra vantagem de adaptação sobre o aprendizado local à tarefa comum. A bancada é deliberadamente isolada do reticulado de vereditos: pontuações aprendidas podem propor candidatos; só controles, cobertura e revisão independente podem sustentar uma alegação sobre cifra histórica.
5.2 O Que Falhou
Na base de código v1 do Liber Primus, o aparato de ML não foi apenas inútil, mas ativamente enganoso: sua função objetivo classificou um texto claro rotacionado ciclicamente acima do verdadeiro ( contra numa página já resolvida); seu arquivo de qualidade-diversidade colapsou para uma célula; seu ambiente de RL sorteava a única decisão que importava; ele não conseguia recuperar uma chave Vigenère de 3 símbolos que a enumeração exaustiva resolve em menos de um segundo. No predecessor do Voynich, um “pontuador estrutural” foi ajustado a um substituto sintético de 629 caracteres porque uma URL de download quebrada caiu em silêncio num valor padrão, e 21 testes passaram o tempo todo. As duas falhas têm a mesma estrutura: pressão de otimização sobre um objetivo não validado fabrica respostas erradas confiantes.
5.3 Onde a IA Pertence
A IA pertence fora do laço de pontuação: geração de hipóteses, construção de corpus, normalização ortográfica e classificação de candidatos cuja saída um humano revisa e confirma. A IA não pertence dentro do laço de pontuação como juíza, porque um crítico aprendido é uma função objetivo, e as Seções 3.4 e 5.2 mostram o que acontece com funções objetivo sob pressão de otimização em textos cifrados não resolvidos, sem verdade de referência. Abordagens futuras que valem a tentativa: pontuadores neurais como mecanismos de proposta com verificação estatística independente; priors de modelos de linguagem para a inicialização de atribuições homofônicas; mapas de atenção baseados em transformers sobre a estrutura de linhas do voynichês como geradores de hipóteses; e benchmarks controlados em que a resposta correta às vezes está ausente do conjunto de candidatos, para medir taxas de falso positivo.
6. Discussão Comparativa
| Dimensão | Liber Primus | Manuscrito Voynich |
|---|---|---|
| Verdade de referência | Existem páginas resolvidas; controles podem ser construídos a partir de texto claro real | Nenhuma; os controles testariam hipóteses, não ataques |
| Método central | Motor de falsificação com controles como condição de admissão; reticulado de vereditos | Bateria discriminativa contra modelos nulos |
| Principal resultado negativo | Sete classes de cifra excluídas; chave corrida excluída por convolução | Zipf, entropia e rigidez, todas reproduzidas pelo Markov de ordem 2 |
| Principal resultado positivo | Nenhum (sem decifração) | Currier A/B distintos; efeito da linha como unidade (12–23× sobre o nulo) |
| Papel da IA | Aparato de busca que falhou; depois, ataque homofônico variacional | Controle de metaaprendizado; análise de sensibilidade à tokenização |
| Principal limitação | Uma única transcrição da comunidade; homofônica não fechada sob agregação | Uma única tokenização EVA; uma transcrição para os resultados principais |
Os dois projetos convergem na mesma percepção metodológica: em domínios sem verdade de referência, falseabilidade e discriminação são os recursos escassos, não computação nem esperteza. Um resultado negativo confiável se acumula; um resultado positivo que não pode ser conferido, não.
7. Abordagens Que Podem Ser Tentadas
- Liber Primus: testar substituição homofônica sob modelos de texto claro não ingleses (latim, alemão, línguas construídas); estender o argumento da convolução ao pré-achatamento homofônico; fazer ataques específicos por seção em vez de agregados; investigar construções compostas (substituição → transposição → fluxo).
- Voynich: repetir a bateria completa sob tokenizações alternativas (concluído para as compostas; estender às por traços e silábicas com controles adequados, incluindo nulos reajustados sob cada tokenização); testar divisões por caderno (quire) e por mão; implementar mecanismos generativos historicamente significativos (cópia restrita, cifra verbosa, codificação por abreviação/posição) e medir sua falha; acrescentar revisão externa de especialistas do domínio.
- Ambos: construir benchmarks em que a resposta correta às vezes está ausente; usar pontuadores neurais estritamente como mecanismos de proposta com verificação estatística; publicar código e dados calibrados por nulos para que outros possam replicar as exclusões sem repetir buscas fracassadas.
8. Conclusão
As páginas não resolvidas do Liber Primus são estatisticamente indistinguíveis de um one-time pad com , e sete classes de cifra (texto claro sem cifra, substituição monoalfabética, substituição afim, transposição pura, keystreams determinísticos, chaves polialfabéticas periódicas até e chaves corridas em língua natural) são excluídas, cada uma com cobertura e hipóteses declaradas. Uma análise homofônica posterior revela heterogeneidade por seção: três seções compatíveis, uma excluída, duas inconclusivas, a primeira evidência quantitativa de que as páginas não resolvidas podem não ser uma cifra homogênea.
O voynichês segue a lei de Zipf, mas o mesmo faz uma cadeia de Markov de ordem 2 ajustada aos seus próprios glifos; o argumento que vai da conformidade com Zipf ao estatuto linguístico não sobrevive ao contato com um modelo nulo. Entropia condicional, rigidez posicional, comprimento médio das palavras e repetição adjacente são todas reproduzidas por uma cadeia de Markov de primeira ordem. Dois achados sobrevivem aos controles: Currier A e B são populações distintas, e o efeito da linha como unidade funcional, divergência de 12× no nível do glifo e de 23× no nível da palavra sobre um controle pareado, resiste a qualquer cifra de substituição ou transposição de língua natural.
A proposta metodológica é modesta e barata: apresentar toda estatística ao lado de modelos nulos que deveriam reprová-la e amarrar todo ataque a controles de resposta conhecida da mesma classe de cifra. Num campo em que as afirmações positivas não podem ser conferidas, uma disciplina que torna confiáveis as afirmações negativas é a única coisa que se acumula. Nenhum dos dois artefatos está resolvido. Os dois estão mais bem medidos.
Apêndice A. Resultados Formais e Verificações de Consistência
Acrescentado em novembro de 2026. Tudo o que segue é derivado de definições ou recalculado a partir de números que já estavam no artigo; não contém nenhuma medição nova sobre os manuscritos. As afirmações numéricas foram conferidas por simulação ou por cálculo direto.
A.1 A estatística IC sob o nulo uniforme, e o que ela consegue detectar
Para sorteios i.i.d. uniformes sobre símbolos, o IC plug-in tem esperança e, em primeira ordem,
Para e isso dá (uma simulação de Monte Carlo com 6.000 execuções dá e média ). O valor observado fica, portanto, a do valor do one-time pad; o arredondamento dos quatro algarismos significativos publicados move isso em cerca de . A afirmação “estatisticamente indistinguível de um one-time pad” é este cálculo.
Para uma chave periódica de período com deslocamentos uniformes independentes, os pares de posições no mesmo coset colidem com a probabilidade do texto claro e todos os outros pares com , em média; logo,
Com (a barra do texto claro na Figura 1), isso prevê 0,0398, 0,0367 e 0,0354 para , contra 0,0397, 0,0367 e 0,0354 lidos na Figura 1. A mesma fórmula diz que o IC agregado sozinho separa uma chave periódica aleatória do nulo uniforme a apenas enquanto . A varredura por coset até é, portanto, o complemento exato, chave a chave, de um teste agregado cujo alcance para chaves aleatórias é cerca de cinco vezes maior; períodos acima de aproximadamente 295 não são excluídos por nenhum dos dois.
A.2 A identidade da convolução, sua condição exata e um contraexemplo
Seja . Parseval dá com , e para , o que produz a identidade da Seção 3.3. Uma verificação numérica em distribuições aleatórias sobre concorda até a precisão de máquina.
A identidade dá a condição exata para que uma convolução seja uniforme: para todo , ou . Isso é mais fraco que “uma das duas é uniforme”. Por exemplo, sobre tome e . Ambas são estritamente positivas e visivelmente não uniformes, e no entanto sua convolução é exatamente uniforme, porque seus espectros vivem em frequências disjuntas. As distribuições de língua natural não são assim: seus coeficientes de Fourier não se anulam; logo, o excesso é estritamente positivo, e o nulo simulado da Seção 3.3 fornece seu tamanho ().
Mais uma ressalva. A identidade é exata para colisões entre posições cujos símbolos são independentes. Textos claros e chaves reais são correlacionados em defasagens curtas, o que muda a probabilidade de colisão dos pares que estão a poucos caracteres de distância. Esses pares são uma fração de cerca de de todos os pares, para um comprimento de correlação ; com e isso é menos de , de modo que o viés é de ordem no máximo, uma ordem de grandeza abaixo dos que separam o nulo da chave corrida da observação. O nulo empírico já contém o efeito.
A.3 Viés do estimador e o alcance de
A correção de Miller–Madow soma bits à entropia plug-in, em que é o número de células ocupadas. Para os 676 contextos de uma tabela de bigramas com glifos, isso é bit, desprezível, e é por isso que o corrigido e o bruto concordam. O número de contextos cresce geometricamente com o comprimento do contexto, por um fator de cerca de 26 por glifo acrescentado, para um alfabeto de 26 glifos, e ultrapassa em poucos passos (). As estimativas plug-in de passam então a ser dominadas pela amostra finita, e é por isso que todas as curvas da Figura 5 caem. Só a comparação entre o manuscrito e um nulo do mesmo comprimento, estimado do mesmo modo, tem sentido, e é essa a comparação feita na Seção 4.6.
A.4 Por que a comparação com a tokenização composta precisa de um nulo reajustado
A entropia depende do alfabeto. Fundir ch, sh, cth em tokens únicos troca vários símbolos por um, mudando tanto o número de símbolos quanto a distribuição condicional. Um valor de calculado no alfabeto composto (2,224) e um nulo ajustado no alfabeto EVA (2,114) são estatísticas de variáveis aleatórias diferentes. A comparação só é válida contra uma cadeia de Markov de ordem 2 ajustada ao texto tokenizado de forma composta e amostrada no mesmo alfabeto. Esse é um cálculo finito sobre a mesma transcrição e consta da Seção 7.
A.5 Heterogeneidade entre as seis seções
Se todas as seis seções viessem de uma única cifra, seus escores compartilhariam um valor comum, a menos de ruído, e a estatística seguiria uma distribuição com graus de liberdade. Da tabela da Seção 3.5, e . A função de sobrevivência de nesse valor é cerca de . Os escores vêm de nulos empíricos finitos e são apenas aproximadamente normais; portanto o expoente não deve ser tomado literalmente, mas nenhum desvio plausível da normalidade leva a probabilidade perto dos limiares convencionais. O recalculado para cada linha, , concorda com o valor impresso dentro do arredondamento: , , , , , .
A.6 Uma rotação custa no máximo um punhado de gramas
Tome um texto de símbolos e corte-o e rotacione-o em qualquer ponto. Para -gramas, o texto rotacionado mantém exatamente dos gramas originais; só os gramas que atravessavam o corte se perdem, e surgem novos na junção (verificado por contagem direta para ). Para isso é de . Se as log-probabilidades por grama estão numa faixa de largura , a log-verossimilhança total de uma rotação difere da do original em no máximo , e a média por grama em no máximo , uma quantidade que some como . Um pontuador construído sobre tais estatísticas não consegue distinguir com confiabilidade uma rotação da verdade numa página de qualquer comprimento; a inversão observada ( contra ) é o comportamento esperado do objetivo, não um acaso da busca.
Notas de revisão
Alterações feitas no texto do preprint para esta versão web (novembro de 2026), para que os leitores do PDF original vejam exatamente o que mudou:
- Resumo e Seção 4.4: a razão no nível do glifo é dada como 12× (o corpo dá 12,3×); o resumo do PDF dizia 13×.
- Seção 3.1: acrescentada a linha “Texto claro sem cifra”, que o resumo e a conclusão contam entre as sete classes excluídas, mas a tabela omitia. As entradas de espaço de chaves ilegíveis no PDF foram preenchidas a partir das definições (, ).
- Seções 2.1 e 3.3: a condição para uma convolução ser uniforme estava enunciada como “uma das duas distribuições é exatamente uniforme”; a condição exata é suporte espectral disjunto (Apêndice A.2). A conclusão para chaves em língua natural não muda.
- Seção 3.4: ” dos quadrigramas sobrevivem” é de (Apêndice A.6). O número vale para trigramas, de um total de .
- Seção 3.5: o cabeçalho de coluna e o limite de probabilidade ilegíveis foram substituídos pelas definições de , , , e pela estatística de heterogeneidade do Apêndice A.5. A convenção dos vereditos (sinal de ) está explícita; ela foi lida da tabela e deve ser confirmada no código.
- Seção 4.5: removida a afirmação de que a tokenização composta “move para acima do nulo de ordem 2”, que comparava valores de alfabetos diferentes (Apêndice A.4).
- Seção 4.6 e legenda da Figura 5: o texto dizia que a taxa de entropia converge para o nulo de Markov-2; a Figura 5 mostra concordância apenas em e uma diferença crescente abaixo do nulo em –5. O parágrafo agora diz isso.
- Apêndice A foi acrescentado.
Pontos em aberto para o autor, não alterados aqui: as definições das classes “transposição pura” (161 chaves) e “keystream teórico-numérico determinístico” (6.144 chaves) não constam do texto; o de base é 2,121 na Seção 4.3 e 2,081 na Seção 4.5 e na Figura 5, e a diferença não é explicada; e as referências aos manuscritos companheiros (2026a–d) são autopublicadas e não têm link.
Referências
- Friedman, W. F. (1922). The Index of Coincidence and Its Applications in Cryptography. Riverbank Publications, 22.
- Knuth, D. E. (1994). A Decryption of a Homophonic Cipher. Cryptologia, 18(3), 267–284.
- Sinkov, A. (1966). Elementary Cryptanalysis: A Mathematical Approach. Mathematical Association of America.
- Currier, P. (1976). Statistical Analysis of the Voynich Manuscript. Manuscrito inédito.
- Zandbergen, R. & Landini, G. (2020). Voynich Manuscript Transcriptions, ZL3b-n. voynich.nu.
- Soranço, M. (2026a). Liber Primus: A Falsification Engine. Manuscrito autopublicado, 12 pp. Código: github.com/Matheussoranco/LiberPrimus.
- Soranço, M. (2026b). Voynich: Measuring the Manuscript Against Things That Mean Nothing. Manuscrito autopublicado, 13 pp. Código: github.com/Matheussoranco/Voynich.
- Soranço, M. (2026c). Homophonic Substitution in the Liber Primus: A Variational Analysis. Manuscrito autopublicado.
- Soranço, M. (2026d). Alternative Tokenisation and Line-Structure Analysis of the Voynich Manuscript. Manuscrito autopublicado.
- Li, M. & Vitányi, P. (2008). An Introduction to Kolmogorov Complexity. Springer.
- Cover, T. M. & Thomas, J. A. (2006). Elements of Information Theory. Wiley.
Comentários
Ainda não há comentários. Seja o primeiro a comentar «Medindo o Insolúvel: um estudo comparativo do Liber Primus (Cicada 3301) e do Manuscrito Voynich».
Entre ou crie uma conta para curtir, comentar e receber os próximos textos por e-mail.